Computador para rodar IA local: quanta memória o modelo pede e que máquina comprar
Calculamos quanta memória cada modelo de IA ocupa e comparamos DGX Spark, GB10 de parceiros, Mac Studio, mini PC com Ryzen AI Max+ 395 e PC com RTX pela ficha oficial.
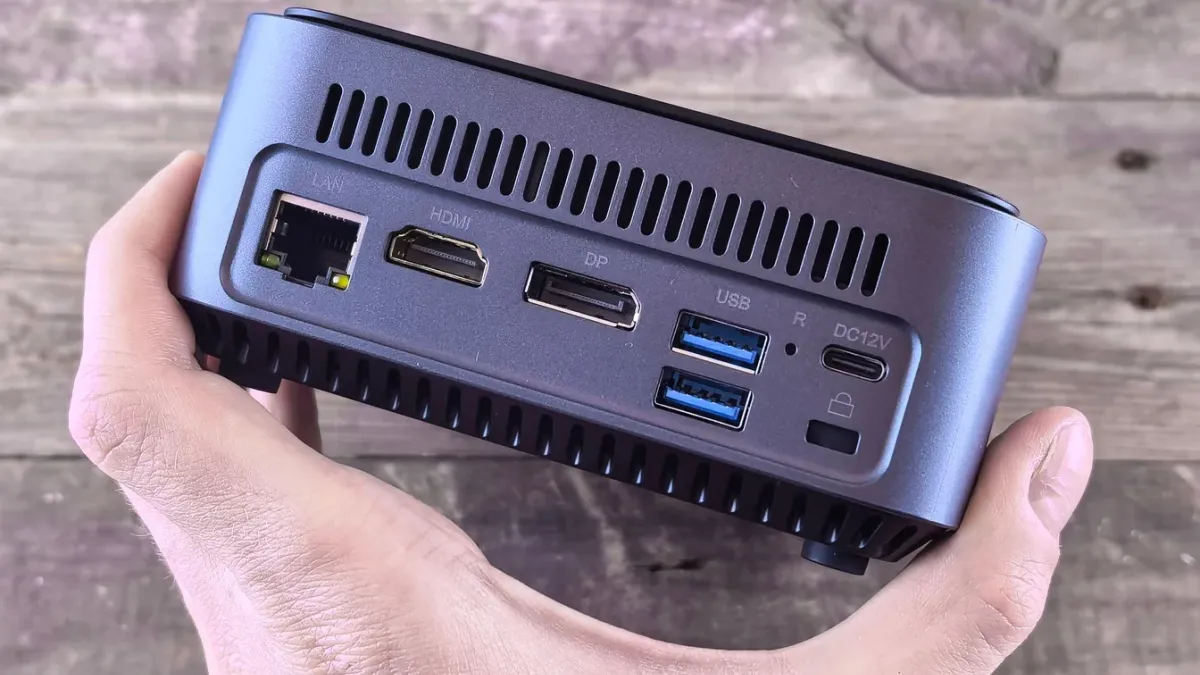
O computador para rodar IA local certo é o que tem memória para o modelo que você quer usar: até 14 bilhões de parâmetros, um PC com placa RTX de 16 GB resolve; de 70 a 120 bilhões, entram as máquinas de 128 GB de memória unificada (NVIDIA DGX Spark, GB10 de parceiros como ASUS Ascent GX10 e Dell, mini PCs com AMD Ryzen AI Max+ 395 e Mac Studio com M5 Max), e, com 128 GB, o DGX Spark e as GB10 vão a 200 bilhões, segundo a NVIDIA. Acima disso, só o Mac Studio com M5 Ultra, de até 512 GB, ou dois DGX Spark em rede.
Escolha primeiro o tamanho do modelo, depois o software (CUDA, MLX ou ROCm) e só então o consumo e o tamanho da máquina.
Como montamos este guia
Não testamos as máquinas. Os números vêm das fichas oficiais da NVIDIA, ASUS, Dell, Apple e AMD (conferidas em 7 de novembro de 2026) e da documentação do llama.cpp, o programa de código aberto que a AMD usa nos testes de IA local. As contas de energia e velocidade são nossas. Link de loja só aparece em anúncio novo de loja confiável (loja oficial ou vendedor com vendas e boa avaliação) na Amazon, no Mercado Livre ou na Shopee.
Quanta memória para rodar LLM em casa?
O modelo é um arquivo de pesos, e ele inteiro precisa caber na memória que a placa de vídeo (ou o chip com memória unificada) usa. Se não couber, parte vai para a memória comum e o processador, e a velocidade despenca.
memória em GB ≈ parâmetros em bilhões × bits por peso ÷ 8, mais a folga do contexto
Dividir por 8 converte bits em bytes, e bilhões de bytes são gigabytes.
Os bits por peso dependem da quantização, a compressão do modelo. Num modelo de 8 bilhões, a documentação do llama.cpp mede 16 bits por peso no F16 (sem compressão), 8,5 no Q8_0 e 4,89 no Q4_K_M, que a AMD aponta como a quantização mais usada no llama.cpp. A mesma documentação do llama.cpp dá o Llama 3.1 em Q4_K_M com 4,9 GB no de 8 bilhões, 43,1 GB no de 70 bilhões e 249,1 GB no de 405 bilhões. A fórmula dá 42,8 GB para o de 70 bilhões, então a conta bate.
| Tamanho do modelo | Q4_K_M (4,89 bits) | Q8_0 (8,5 bits) | F16 (16 bits) |
|---|---|---|---|
| 8 bilhões | 4,9 GB | 8,5 GB | 16 GB |
| 14 bilhões | 8,6 GB | 14,9 GB | 28 GB |
| 32 bilhões | 19,6 GB | 34 GB | 64 GB |
| 70 bilhões | 42,8 GB | 74,4 GB | 140 GB |
| 120 bilhões | 73,4 GB | 127,5 GB | 240 GB |
| 405 bilhões | 247,6 GB | 430,3 GB | 810 GB |
Três cuidados com a tabela:
- Some folga para o contexto. A tabela é só dos pesos, e o histórico da conversa ocupa mais memória quanto maior a janela. A AMD roda o Llama 4 Scout com 256 mil tokens de contexto, mas com o Flash Attention ligado e o cache comprimido em Q8.
- Modelo MoE conta pelo total. Na "mistura de especialistas", só parte dos parâmetros trabalha a cada palavra, mas todos ficam na memória. O Llama 4 Scout tem 109 bilhões no total e 17 bilhões ativos, segundo a AMD; para a memória, vale o 109.
- Menos bits, menos precisão. A documentação do llama.cpp avisa que a quantização pode perder precisão, medida em perplexidade.
O que deixa a IA local mais rápida: memória ou chip?
Depois de caber, a velocidade depende da largura de banda da memória. Para escrever cada palavra, o modelo lê os pesos ativos, e essa leitura costuma limitar a resposta. O teto é a largura de banda dividida pelo tamanho do modelo. Com o Llama 3.1 de 70 bilhões em Q4_K_M (43,1 GB):
| Máquina | Largura de banda (ficha) | Teto teórico com 70B em Q4_K_M |
|---|---|---|
| DGX Spark e GB10 de parceiros | 273 GB/s | cerca de 6 palavras por segundo |
| Ryzen AI Max+ 395 (LPDDR5x-8000, 256 bits) | 256 GB/s (blog da AMD) | cerca de 6 por segundo |
| Mac Studio M5 Max (GPU de 40 núcleos) | 614 GB/s | cerca de 14 por segundo |
| Mac Studio M5 Ultra | 1,2 TB/s | cerca de 28 por segundo |
O número real fica abaixo do teto, e "palavra" aqui é token, que a AMD compara a uma palavra. A conta: 273 ÷ 43,1 = 6,3; 256 ÷ 43,1 = 5,9; 614 ÷ 43,1 = 14,2; 1.200 ÷ 43,1 = 27,8. A ficha do chip não dá GB/s; o blog da AMD cita 256, que são 8.000 milhões de transferências por segundo vezes 32 bytes (256 bits).
Num modelo denso de 70 bilhões, as máquinas de 128 GB com 256 a 273 GB/s ficam em cerca de 6 tokens por segundo no teto; com modelos MoE, que leem só os parâmetros ativos, o teto sobe na mesma proporção.
Comparativo: as cinco categorias de computador para rodar IA local
| DGX Spark | GB10 de parceiros | Mac Studio | Mini PC Ryzen AI Max+ 395 | PC com RTX | |
|---|---|---|---|---|---|
| Memória para IA | 128 GB unificada | 64 ou 128 GB unificada | 36 a 128 GB (M5 Max) ou 96 a 512 GB (M5 Ultra) | até 128 GB (até 96 GB para a GPU no Windows) | 16 GB (5060 Ti) ou 32 GB (5090) de VRAM |
| Largura de banda | 273 GB/s | 273 GB/s | 460 a 614 GB/s (M5 Max) ou 1,2 TB/s (M5 Ultra) | 256 GB/s (AMD) | interface de 128 bits (5060 Ti) ou 512 bits (5090) |
| Maior modelo (fabricante ou conta) | 200 bilhões (NVIDIA) | 100 ou 200 bilhões, conforme a memória (NVIDIA) | 405 bilhões em Q4_K_M com 512 GB (conta) | 128 bilhões (AMD) | 14 bilhões (16 GB) ou 32 bilhões (32 GB) em Q4_K_M (conta) |
| Energia | fonte de 240 W | fonte de 240 W (ASUS) ou 280 W (Dell) | até 480 W contínuos | chip de 45 a 120 W | placa de 180 W (5060 Ti) ou 575 W (5090) |
| Sistema | DGX OS (Ubuntu, Arm) | DGX OS (Ubuntu, Arm) | macOS | Windows ou Linux | Windows ou Linux |
| Software de IA | CUDA | CUDA | MLX e Metal | ROCm e Vulkan | CUDA |
NVIDIA DGX Spark: o computador para rodar IA local com CUDA e 128 GB
A máquina de mesa da NVIDIA para IA usa o superchip GB10 Grace Blackwell: um processador Arm de 20 núcleos (10 Cortex-X925 e 10 Cortex-A725) e uma GPU Blackwell na mesma peça, com 128 GB de LPDDR5X unificada a 273 GB/s. A caixa tem 150 × 150 × 50,5 mm e 1,2 kg.
Ficha (NVIDIA):
- Até 1 petaflop em FP4, valor teórico com esparsidade.
- Até 4 TB NVMe com criptografia.
- ConnectX-7 de 200 Gbps com duas portas QSFP, Ethernet de 10 GbE, Wi-Fi 7.
- Fonte externa de 240 W; o GB10 tem TDP de 140 W.
- NVIDIA DGX OS, baseado no Ubuntu.
Que modelo roda. A NVIDIA fala em inferência de até 200 bilhões de parâmetros e ajuste fino de até 70 bilhões numa unidade. A página não diz a precisão; com 4 bits por peso, seriam 100 GB pela nossa conta, com folga nos 128 GB.
Software. Tudo o que roda em CUDA roda aqui. A NVIDIA inclui PyTorch, Jupyter e os microsserviços NIM, e o Ollama lista o GB10 entre as GPUs compatíveis.
Pontos de atenção. Com Arm e Linux, não roda Windows, e programa só para x86 pode não ter versão. A largura de banda é quase a dos mini PCs com Ryzen AI Max+ 395 (273 contra 256 GB/s), então o teto em modelos densos grandes fica parecido.
Para quem é. Desenvolvedor e empresa pequena que já usam NVIDIA, querem testar modelos de até 200 bilhões ou fazer ajuste fino sem pagar nuvem e aceitam Linux.
O que dizem os compradores. Em 7 de novembro de 2026, o DGX Spark tinha uma única avaliação no Mercado Livre, sem comentário, e não era vendido na Amazon Brasil.
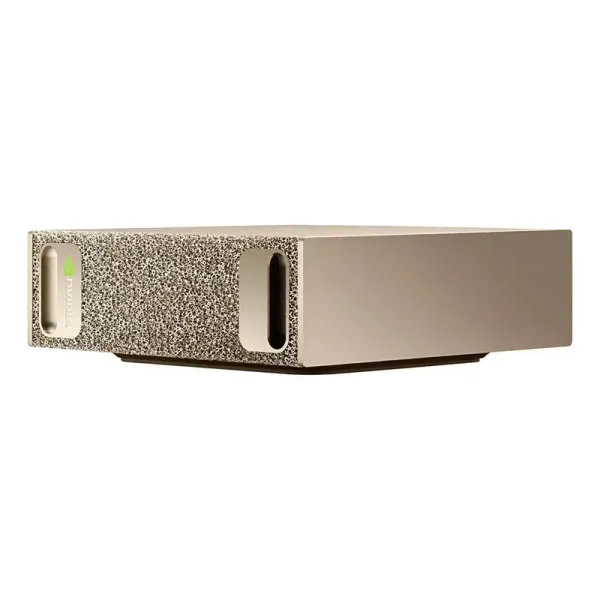
NVIDIA DGX Spark 128 GB (SSD de 4 TB)
a partir de R$ 69.999Ainda sem avaliações suficientes de compradores no Brasil (conferido em 11/2026)Mini PC da NVIDIA com o superchip GB10 Grace Blackwell e 128 GB de memória unificada, feito para rodar e ajustar modelos de IA de até 200 bilhões de parâmetros na mesa.
- Marca: NVIDIA
- Modelo: DGX Spark (940-54242-0000)
- Chip: GB10 Grace Blackwell, CPU Arm de 20 núcleos
- Memória: 128 GB LPDDR5x unificada, 273 GB/s
- Armazenamento: SSD NVMe de 4 TB
- Desempenho de IA: até 1 petaFLOP em FP4
- Rede: ConnectX-7 de 200 Gb/s e 10 GbE
- Sistema: DGX OS (Ubuntu)
ASUS Ascent GX10, Dell com GB10 e as outras GB10: vale mais que o DGX Spark?
A NVIDIA lista sete parceiros com máquinas GB10: Acer, ASUS, Dell, Gigabyte, HP, Lenovo e MSI. Chip, memória de 273 GB/s e DGX OS são os do DGX Spark. Mudam armazenamento, fonte, garantia e suporte.
ASUS Ascent GX10. 64 ou 128 GB de LPDDR5X-8533, SSD de 1 ou 2 TB PCIe 4.0 ou de 4 TB PCIe 5.0 num único slot M.2, ConnectX-7, rede de 10G, HDMI 2.1a, fonte de 240 W e 1,48 kg. Com 64 GB, a NVIDIA fala em 100 bilhões de parâmetros.
O que dizem os compradores. Na Amazon, a GX10 tem nota 4,0 em 94 avaliações, quase todas de compradores dos EUA. Eles elogiam rodar modelos de até 120 bilhões de parâmetros no Ollama e no vLLM e reclamam do throttling (o chip reduz a velocidade quando esquenta), da banda de memória, que impede duas unidades juntas de ganhar velocidade, e de uma fonte que chegou com defeito. No Mercado Livre, ainda não há avaliações.
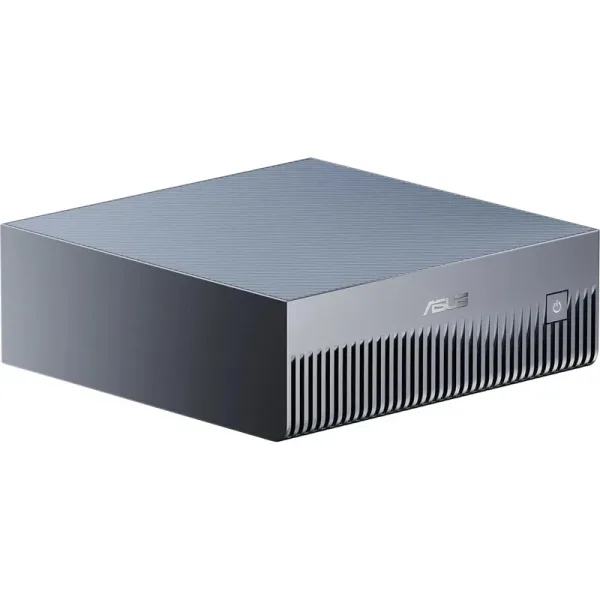
ASUS Ascent GX10 128 GB (GX10-GG0020BN)
a partir de R$ 56.550,90Versão da ASUS para o GB10 Grace Blackwell da NVIDIA, com 128 GB de memória unificada e a mesma pilha de software do DGX Spark.
- Marca: ASUS
- Modelo: Ascent GX10 (GX10-GG0020BN)
- Chip: NVIDIA GB10 Grace Blackwell, CPU Arm de 20 núcleos
- Memória: 128 GB LPDDR5x unificada
- Desempenho de IA: até 1 petaFLOP em FP4
- Rede: ConnectX-7 de 200 Gb/s
- Sistema: NVIDIA DGX OS
- Roda modelos de até 120 bilhões de parâmetros via Ollama e vLLM, segundo quem comprou na Amazon
- Eficiente e confiável em cluster, segundo os compradores
- Throttling térmico, segundo quem comprou
- A banda de memória limita: empilhar duas unidades não acelera, segundo compradores
- Preço alto
- As 94 avaliações da Amazon são, na maioria, de compradores dos EUA; no Mercado Livre ainda não há avaliações
Dell com GB10. Na loja americana da Dell, a página cujo endereço traz Dell Pro Max with GB10 chama a máquina de Dell Pro Precision with GB10. Tem 64 ou 128 GB de LPDDR5x a até 8.533 MT/s, SSD de 1 a 4 TB, DGX OS 7, 10GbE e ConnectX-7 com duas portas QSFP de 200G. A fonte é um carregador USB-C de 280 W. Ainda não achamos a Dell com GB10 nova, de loja confiável, na Amazon, no Mercado Livre ou na Shopee.
Qual GB10 escolher. Com 128 GB, as três fazem o mesmo trabalho. Decida pela garantia e pelo suporte no Brasil, pelo SSD (o Llama 3.1 de 405 bilhões em Q4_K_M tem 249 GB) e pelo preço do dia. Evite a de 64 GB se o plano é passar de 70 bilhões.
Mac Studio com M5 Max ou M5 Ultra: a máquina com mais memória para IA
É a única da lista que passa de 128 GB numa caixa só. Com o M5 Ultra, a memória unificada vai a 512 GB, a 1,2 TB/s, a maior largura de banda deste guia. Com o M5 Max, vai a 128 GB, a 460 GB/s (614 GB/s com a GPU de 40 núcleos).
Ficha (Apple):
- M5 Max: CPU de 18 núcleos, GPU de 32 ou 40 núcleos, 36 GB na base e opções de 48, 64 ou 128 GB. A de 128 GB exige a GPU de 40 núcleos.
- M5 Ultra: CPU de 30 ou 36 núcleos, GPU de 64 ou 80 núcleos, 96 GB na base e opções de 256 ou 512 GB. A de 512 GB exige a CPU de 36 e a GPU de 80 núcleos.
- Até 16 TB de armazenamento no M5 Ultra.
- Potência contínua máxima de 480 W.
- 9,5 cm de altura, 19,7 cm de lado e 2,7 kg (M5 Max) ou 3,6 kg (M5 Ultra).
Que modelo roda. A Apple não dá limite de parâmetros, mas a página do Mac Studio fala em rodar LLMs localmente e cita, nas notas, testes com um modelo denso de 72 bilhões no mlx-lm. Pela tabela, 512 GB levam o de 405 bilhões em Q4_K_M (247,6 GB) ou, com pouca folga, em Q8_0 (430,3 GB).
Software. O MLX, biblioteca da Apple para aprendizado de máquina, foi feito em torno da memória unificada: os dados ficam na memória compartilhada, sem cópia entre CPU e GPU. O Ollama acelera pela API Metal, e a Apple cita o LM Studio. Ferramenta que só existe em CUDA não roda no Mac.
Pontos de atenção. A memória é soldada e não se amplia depois.
Para quem é. Quem quer o maior modelo possível numa máquina silenciosa que também serve de computador de trabalho, e quem já usa macOS. Ainda não achamos o Mac Studio com M5 novo, de loja confiável, na Amazon, no Mercado Livre ou na Shopee.
Mini PC com AMD Ryzen AI Max+ 395 para IA: 128 GB e Windows
É um processador x86 da AMD que junta CPU, GPU e NPU com até 128 GB de LPDDR5x-8000 em 256 bits. A AMD lista, entre os desktops com 128 GB, o Corsair AI Workstation 300, o HP Z2 Mini G1a e o Framework Desktop, e outras marcas usam o mesmo chip.
Ficha (AMD):
- CPU de 16 núcleos e 32 threads, até 5,1 GHz.
- GPU Radeon 8060S com 40 unidades de computação.
- NPU de até 50 TOPS e até 126 TOPS somando tudo.
- TDP de 55 W no padrão, configurável de 45 a 120 W pelo fabricante do PC.
Que modelo roda. No Windows, a AMD deixa reservar até 96 GB dos 128 GB como memória de vídeo (Variable Graphics Memory) e anuncia modelos de até 128 bilhões no llama.cpp com Vulkan, a partir do driver Adrenalin 25.8.1. Pela tabela, 96 GB levam o de 70 bilhões em Q4_K_M com boa folga e o de 120 bilhões (73,4 GB) com cerca de 22 GB livres.
Software. No Linux, o Ollama usa o ROCm, o equivalente da AMD ao CUDA, e lista o Ryzen AI Max+ 395 (gfx1151) como compatível com o ROCm 7. No Windows, o caminho mais simples é o Vulkan, que segundo o Ollama já vem na maioria dos drivers; é por ele que a AMD roda o llama.cpp no LM Studio. O ecossistema é menor que o do CUDA.
Pontos de atenção. Veja se o anúncio tem 128 GB: há aparelhos com o mesmo chip e 64 GB ou menos, e a memória não se troca. Olhe também o TDP na ficha, porque ele muda o desempenho de um aparelho para outro.
Para quem é. Quem quer rodar 70 bilhões ou MoE de cerca de 100 bilhões num PC com Windows que também roda jogos e gasta menos energia que um PC com placa grande. Ainda não achamos mini PC novo com esse chip e 128 GB, de loja confiável, na Amazon, no Mercado Livre ou na Shopee.
PC com RTX para rodar IA local: o mais rápido para modelos de até 32 bilhões
O PC com GeForce é o caminho mais conhecido e o mais fácil de ampliar. Aqui a conta é a VRAM da placa, pouca e muito rápida. CUDA completo, no Windows ou no Linux, e o Ollama lista as RTX da série 50, da 5060 à 5090, entre as compatíveis.
RTX 5090. 32 GB de GDDR7 em 512 bits (o dobro da largura do GB10 e do Ryzen) e 3.352 AI TOPS, segundo a NVIDIA. Roda 32 bilhões em Q4_K_M (19,6 GB) com muita folga para contexto; em Q8_0 (34 GB), não cabe inteiro. A placa tem potência total de 575 W, e a NVIDIA indica fonte de 1.000 W para um PC com Ryzen 9 9950X.
A RTX 5090 do link abaixo não tinha avaliações no Mercado Livre e tinha só uma na Amazon Brasil em 7 de novembro de 2026.
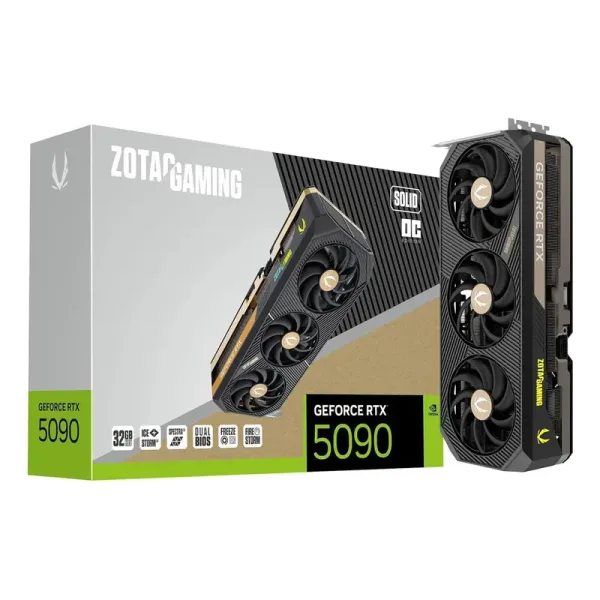
Zotac Gaming GeForce RTX 5090 Solid OC 32 GB
a partir de R$ 57.499Ainda sem avaliações suficientes de compradores no Brasil (conferido em 11/2026)Placa de vídeo topo de linha da NVIDIA, com 32 GB de GDDR7 em barramento de 512 bits, a maior VRAM de uma GeForce para rodar modelos de IA no PC.
- Marca: Zotac
- Modelo: Gaming GeForce RTX 5090 Solid OC (ZT-B50900J-10P)
- GPU: NVIDIA GeForce RTX 5090
- Memória: 32 GB GDDR7
- Barramento: 512 bits
RTX 5060 Ti de 16 GB. A entrada sensata para IA local com CUDA: 16 GB de GDDR7 em 128 bits, 759 AI TOPS, 180 W e fonte de 600 W no sistema. Roda 8 bilhões em qualquer formato da tabela e 14 bilhões em Q4_K_M (8,6 GB) com folga. Fuja da versão de 8 GB, que não leva nem o de 8 bilhões em Q8_0 (8,5 GB).
A 5060 Ti do link abaixo tem nota 4,9 em 35 avaliações no Mercado Livre, com elogios ao desempenho. Duas notas 4 trazem ressalvas: uma fala em queda de fps com DLSS 4.0, e a outra, em pouca compatibilidade com apps da Adobe.
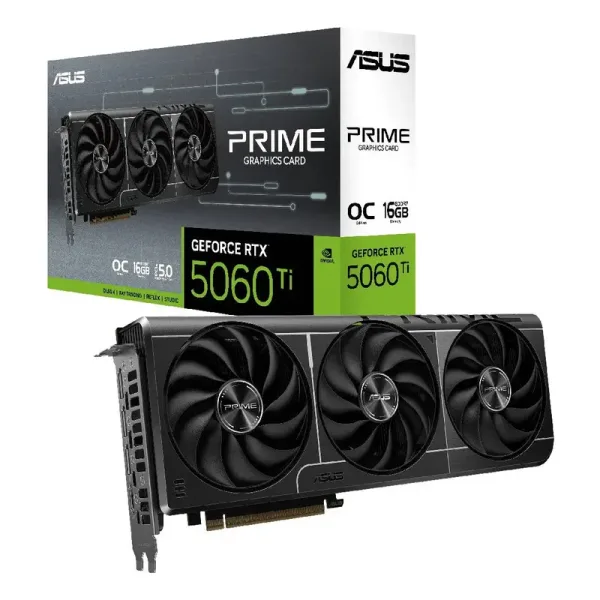
ASUS Prime GeForce RTX 5060 Ti OC 16 GB
a partir de R$ 4.899,99Placa de vídeo de entrada para IA local, com 16 GB de GDDR7, o suficiente para modelos de até 14 bilhões de parâmetros quantizados.
- Marca: ASUS
- Modelo: Prime RTX 5060 Ti OC 16 GB (PRIME-RTX5060TI-O16G)
- GPU: NVIDIA GeForce RTX 5060 Ti
- Memória: 16 GB GDDR7
- Barramento: 128 bits
- Nota 4,9 em 35 avaliações no Mercado Livre, sem nenhuma de 1 a 3 estrelas
- Quem comprou elogia o desempenho
- Queda de fps com DLSS 4.0, segundo um comprador
- Pouca compatibilidade com apps da Adobe, segundo um comprador
Pontos de atenção. Acima de 32 GB, só com duas placas, que exigem fonte, gabinete e placa-mãe próprios: duas RTX 5090 somam 1.150 W só nelas.
Para quem é. Quem quer velocidade com modelos de até 32 bilhões (assistente de código, chat, geração de imagem), quem já tem PC e só troca a placa, e quem também joga.
CUDA, MLX ou ROCm: qual software escolher?
Para só conversar com um modelo, os três servem: o Ollama roda em todos. A diferença aparece em treino e ajuste fino, em que o CUDA (DGX Spark, GB10 e RTX) roda o PyTorch e as ferramentas sem adaptação.
Quanto gasta de energia um servidor de IA para usar em casa?
Potência em quilowatts vezes horas de uso dá o teto, porque a máquina só puxa o máximo sob carga total. Em 8 horas por dia:
- DGX Spark e GB10: 240 W dão 1,92 kWh (5,76 kWh em 24 horas).
- Mac Studio: 480 W contínuos dão 3,84 kWh. A Apple não publica o consumo em uso de IA.
- Mini PC com Ryzen: 120 W dão 0,96 kWh só do chip, sem SSD e ventoinhas.
- PC com RTX 5090: só a placa, a 575 W, gasta 4,6 kWh.
Multiplique pelo preço do kWh da sua conta; em máquina que serve a equipe o dia inteiro, 120 W contra 575 W pesa todo mês.
Melhor computador para IA local: qual escolher para cada tamanho de modelo
- Até 14 bilhões de parâmetros (chat, resumo, código simples): PC com RTX 5060 Ti de 16 GB, a compra mais barata que roda bem.
- Até 32 bilhões, com velocidade e CUDA: PC com RTX 5090.
- 70 bilhões ou MoE de cerca de 100 bilhões, com pouca energia e Windows: mini PC com Ryzen AI Max+ 395 de 128 GB.
- Até 200 bilhões, com CUDA e ajuste fino: DGX Spark ou GB10 de parceiro com 128 GB.
- Acima de 200 bilhões numa máquina só, ou o mais rápido entre as de memória grande: Mac Studio com M5 Ultra de 256 ou 512 GB.
Na dúvida entre dois degraus, suba um: nas máquinas de memória unificada, a memória não se troca depois.
 Leia tambémComo saber se o desconto é real: 7 passos para a Black Friday
Dá para rodar IA local sem placa de vídeo?
Dá, mas devagar: a memória comum do PC tem bem menos largura de banda que a de uma GPU. Para testar, um modelo de 8 bilhões em Q4_K_M (4,9 GB) cabe num PC com 16 GB de RAM.
O DGX Spark roda Windows?
Não. Ele e as GB10 da ASUS e da Dell vêm com o DGX OS, baseado no Ubuntu, sobre processador Arm. Para Windows, olhe o Ryzen AI Max+ 395 ou o PC com RTX.
DGX Spark ou Mac Studio: qual é melhor para IA local?
Para usar modelos grandes, o Mac, com até 512 GB e 1,2 TB/s, contra 128 GB e 273 GB/s do Spark. Para desenvolver e treinar, o Spark, porque tem CUDA.
RTX 5090 roda modelo de 70 bilhões de parâmetros?
Não inteiro: o de 70 bilhões em Q4_K_M ocupa 43,1 GB, e a placa tem 32 GB. O que sobra vai para a memória comum, bem mais lenta.
O que é quantização Q4_K_M?
A quantização de 4 bits que a AMD aponta como a mais usada no llama.cpp: 4,89 bits por peso, menos de um terço dos 16 do F16, pela documentação do llama.cpp.
Dá para juntar dois DGX Spark?
Dá, pela ConnectX-7 de 200 Gbps: a dupla roda até 400 bilhões, segundo a NVIDIA, mas a largura de banda de cada unidade não muda.
Fontes
- NVIDIA: página oficial e especificações do DGX Spark
- ASUS: especificações técnicas do Ascent GX10
- Dell: configuração do Dell Pro Precision (Pro Max) with GB10
- Apple: especificações técnicas do Mac Studio (M5 Max e M5 Ultra)
- Apple: página do Mac Studio (IA e notas de teste)
- AMD: especificações do Ryzen AI Max+ 395
- AMD: Ryzen AI Max+ roda LLMs de até 128 bilhões de parâmetros no Windows
- AMD: perguntas frequentes sobre Variable Graphics Memory e tamanho de modelos
- NVIDIA: especificações da GeForce RTX 5090
- NVIDIA: especificações da família GeForce RTX 5060
- Ollama: documentação de GPUs compatíveis (CUDA, ROCm, Metal e Vulkan)
- llama.cpp: documentação do llama-quantize (bits por peso e tamanhos)
- Apple: repositório oficial do MLX
Sobre os links e preços: o webbusca pode receber uma pequena comissão quando você compra pelos links das lojas citadas, sem custo extra para você. Isso não muda quais produtos indicamos. Os preços foram conferidos em novembro de 2026 e podem mudar, e a disponibilidade depende do estoque de cada loja. Como escolhemos os produtos.